注目キーワード
推論コスト・電力効率・専用半導体・ベンチマーク
このニュースのポイント
- 韓国HyperAccelはSC26で8基のLPUを搭載するサーバーと遠隔推論デモを披露する予定。
- 同社の内部測定では、指定GPU搭載機との比較で消費電力・費用あたりのトークン処理量がそれぞれ3.5倍超。
- 推論コストを下げる専用半導体の競争は、GPU中心のAIインフラ市場の選択肢を広げる可能性がある。
- 測定条件の開示、第三者による検証、顧客採用と実際の収益化が焦点。
ニュース概要
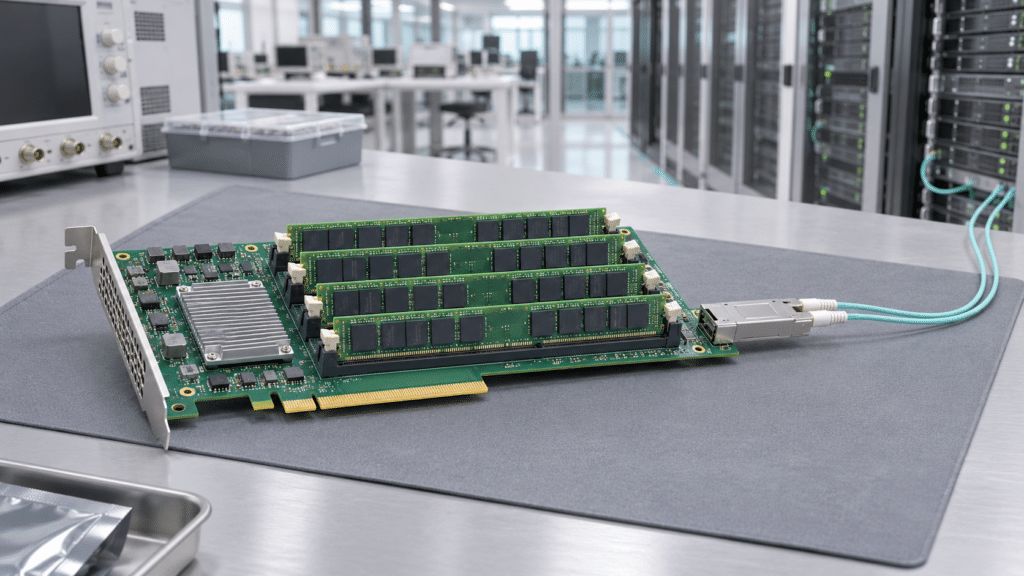
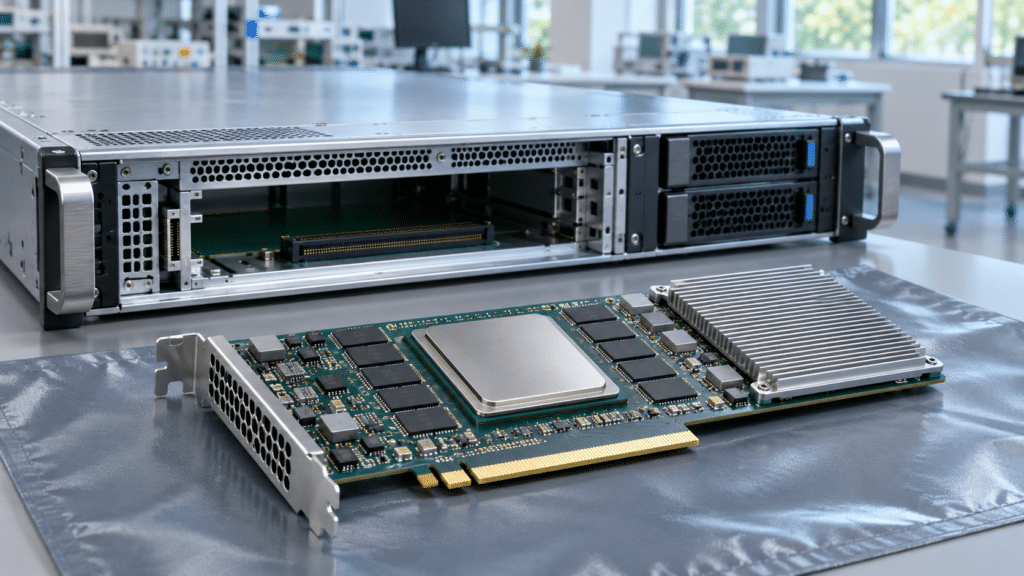
韓国の半導体設計企業HyperAccelは11月12日、米シカゴで開催されるSC26に合わせ、8基の大規模言語モデル向け推論プロセッサー(LPU)を搭載したサーバーを展示すると発表した。韓国で稼働するサーバーを使い、遠隔で推論処理を実演する計画だ。実演は予定であり、商用の大規模受注を意味しない。
SECTORON INSIGHT
SECTORONは、推論の競争がチップ単体の速度だけでなく、電力・導入費用・ソフトウェアを含めた運用経済性に移っている点に注目する。ただし今回の数字はメーカー自身の測定で、比較先は特定のRTX PRO 6000搭載システムだ。全てのNVIDIA製品や利用条件で優位とは言えない。第三者の再現結果と顧客の継続利用が確認されれば評価を強める一方、対応モデルや導入負担が制約となれば優位性は狭まる。
さらに深く
3.5倍超の主張は何を比べたのか
同社によると、Qwen3-32BとLlama3-70Bを実行した内部測定で、250ワットのLPUカードを搭載したサーバーは、600ワットのNVIDIA RTX PRO 6000 Blackwell Server Editionを使う比較システムに対し、1ワットあたりと1ドルあたりのトークン処理量がそれぞれ3.5倍超だった。カードの消費電力はシステム全体の消費電力ではない。公表文には比較対象の構成や測定条件の詳細が十分示されておらず、実利用時の性能や総保有費用を断定できない。同社はLPDDR5Xメモリーと独自のデータフロー設計を採用し、メモリー帯域の利用効率を高めたと説明する。推論ではモデルの重みを読み出す速度と電力が重要だが、実際の経済性は応答速度、同時接続数、対応ソフト、保守費用にも左右される。
次に確認すること
11月17〜19日のSC26で実演が実施されるか、測定条件と対応モデルがどこまで公表されるか、サーバー企業やクラウド事業者との具体的な導入契約が続くかを確認したい。
投資用語ガイド
推論
学習済みAIモデルが入力を受けて回答などを生成する処理。
この記事では:利用量が増えるほど、処理速度と電力・運用費のバランスが重要になる。
トークン
言語モデルが文章を処理する際の単位。
この記事では:毎秒の生成量は処理能力の目安だが、モデルや応答条件が異なれば単純比較できない。
LPDDR5X
省電力を重視したメモリー規格の一つ。
この記事では:電力や費用に利点があり得る一方、システム全体の速度は設計や実装にも左右される。
ⓘ 本内容は情報提供を目的としたものであり、特定の金融商品の売買を推奨するものではありません。
著作権・引用について
本記事の著作権および引用・転載に関する取り扱いについては、利用規約をご確認ください。